 柠檬班
第一节课:基础入门
本文目录
针对人群: 零基础想学习python,又怕自己学不会,怀疑自己是不是适合学习编程的童鞋。
课程介绍
Python10行代码加密文件
——三节课让你弄清自己到底适不适合学习编程
针对人群: 零基础想学习python,又怕自己学不会,怀疑自己是不是适合学习编程的童鞋。
这一节课主要是扫盲,很多同学可能连python运行环境都没有搭建好。
python运行环境搭建
python是一门解释型编程语言,python代码是通过python解释器解释后交给计算机执行的。
所以python运行环境的搭建主要是安装python解释器。
python版本区别
目前python有两个大的版本,2.X和3.X。2.X是遗产,3.X是未来。除非特殊情况,新手建议学习3.X。
下载安装python解释器
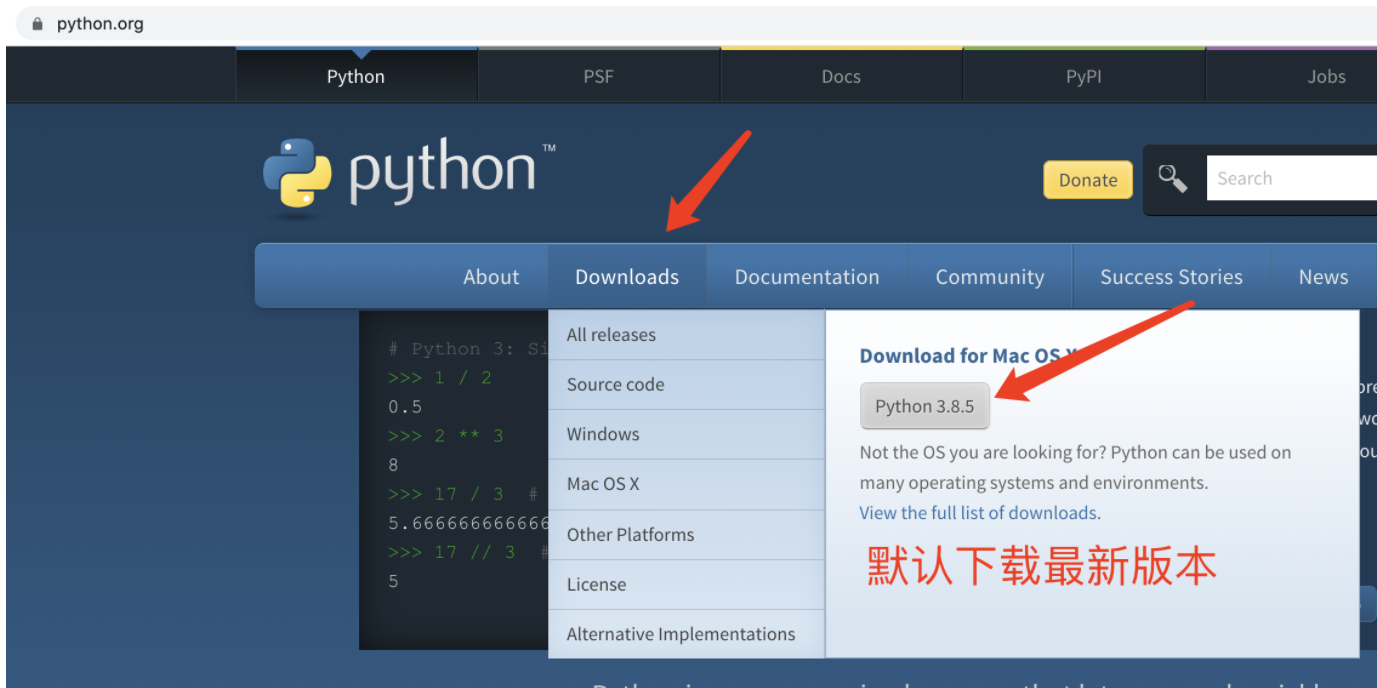
访问python官网,下载解释器安装包。
注意按照操作系统下载对应版本。
下载后双击安装文件会出现如下界面
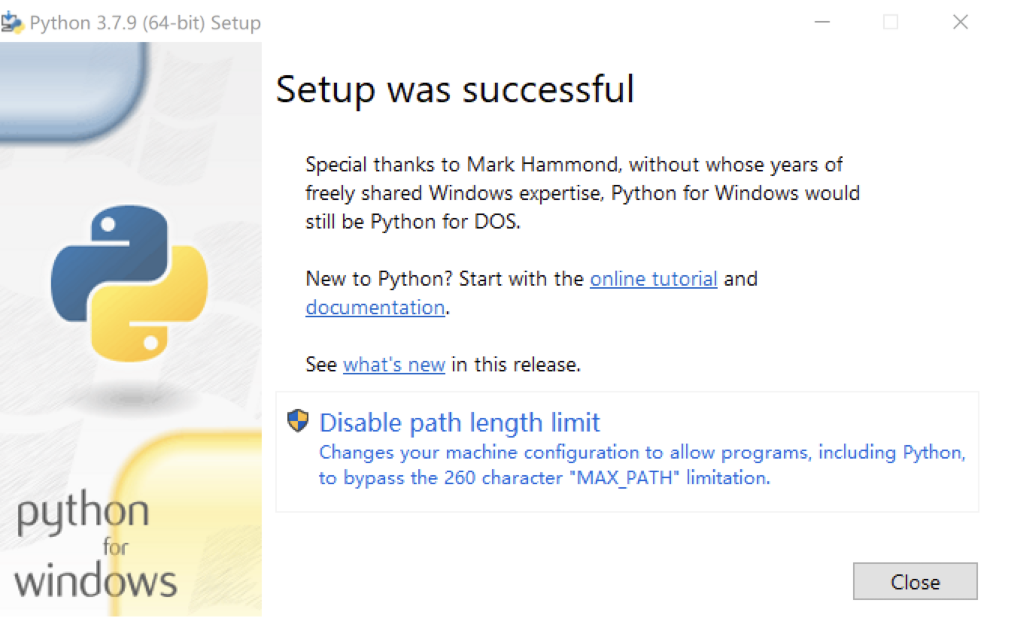
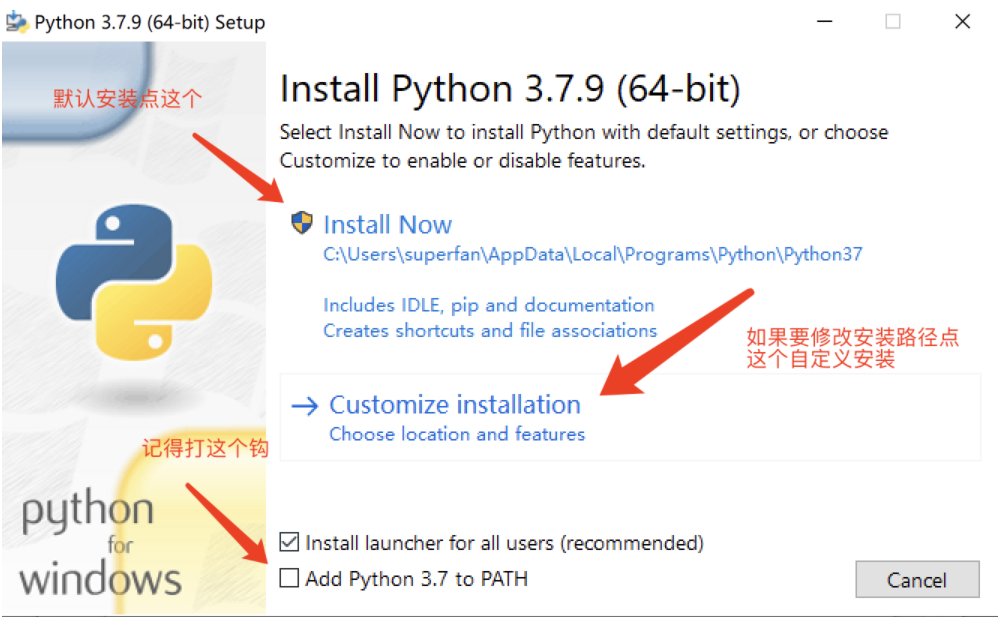 记得勾选添加环境变量,然后就是下一步下一步,一般情况下都会正常安装成功。
cmd命令行工具
全黑的窗口,满屏的像瀑布一样流动的英文,这是电影中黑客出场的画面。
cmd命令行工具就满足这个要求,在windows系统中,win键+R键弹出运行窗口
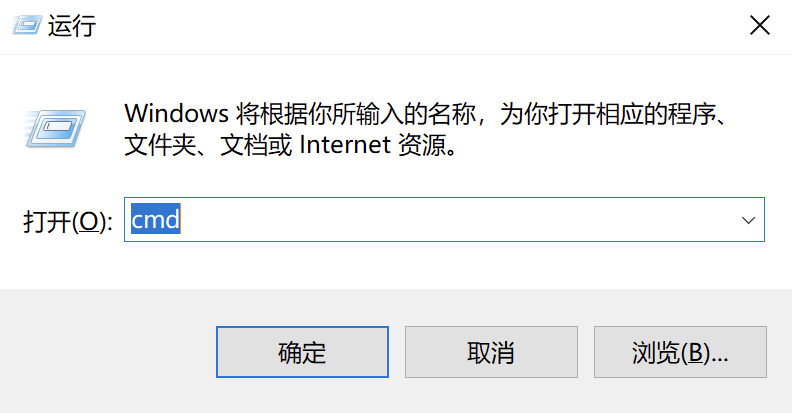
输入cmd确定就会打开命令行工具。
一般情况会打开如下窗口
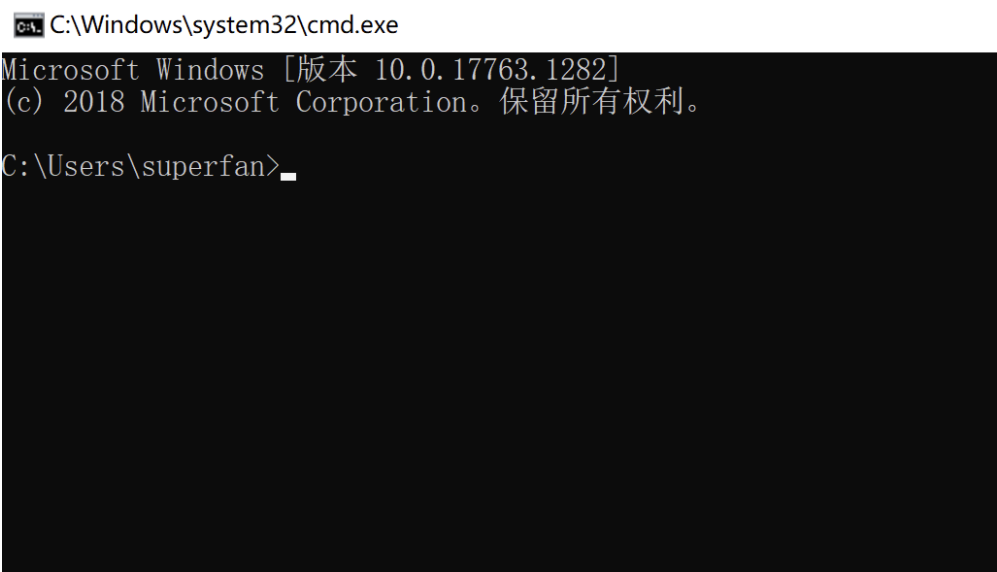 不同版本,可能会有配色的不同,但功能一致。
其实这就是一个名字为cmd.exe的程序,感兴趣的同学可以在电脑中找下它的位置。
它有一个很重要的作用就是能够通过程序名自动调用对应的程序,而不需要去找到可执行文件双击执行。
例如,可以在命令行键入notepad回车,你会发现居然打开了记事本。
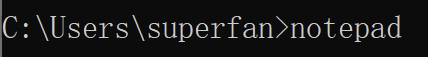
那是因为记事本这个程序的程序名就是notepad.exe,机灵的小可爱就会联想qq的程序名是qq.exe那么,那么在命令行中输入qq是不是也可以打开qq呢?
结果多半如下:
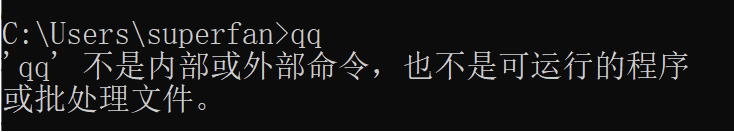
这是为什么呢? 其实cmd在接收到用户输入的命令后,会去电脑中搜索同名的程序或者批处理等文件,但是为了效率,它不会查找每个文件夹。
那它会去哪些文件夹中搜索呢?
环境变量
环境变量其实是一系列常用程序所在路径的集合,记事本程序的路径存在默认的环境变量中所以可以通过命令行打开,qq程序的路径不在环境变量中,所以打不开。
windows系统设置环境变量的步骤如下:
右键【我的电脑】-【属性】-【高级系统设置】-【环境变量】
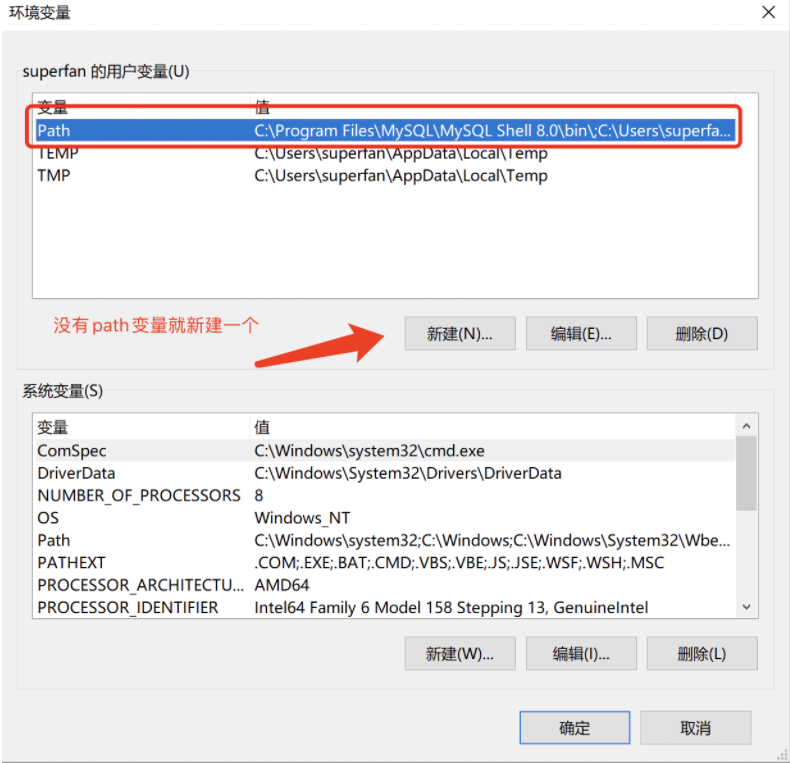
在用户变量中找到环境变量path,如果没有就新建一个path变量。
点击编辑,将qq程序路径添加到path中。
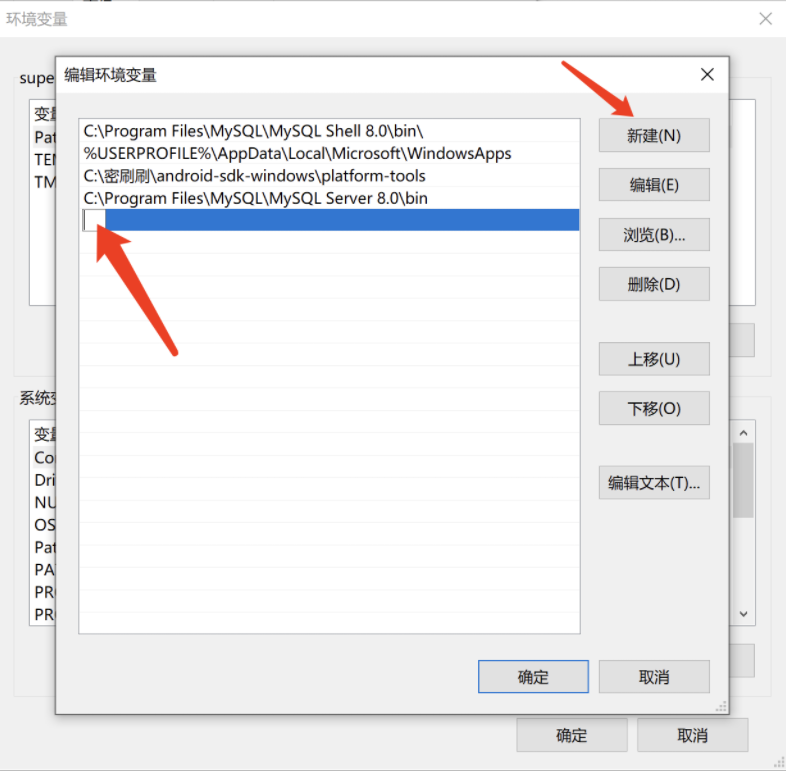 然后重新打开命令行工具应用新的环境变量,再次键入
qq你就可以打开qq啦。
如果在安装python解释器的时候忘记勾选添加环境变量,也可以通过手动设置环境变量,然后在命令行中就可以运行python命令啦。
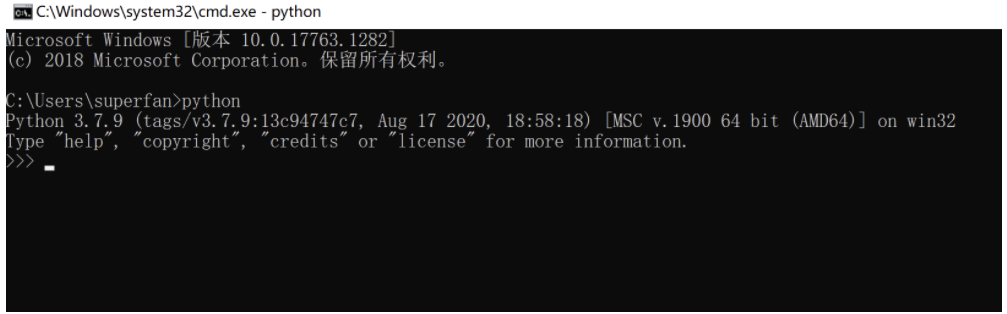
在命令行中键入python命令,出现如下窗口表示运行环境搭建成功。
python代码的运行
python代码的运行方式有两种:
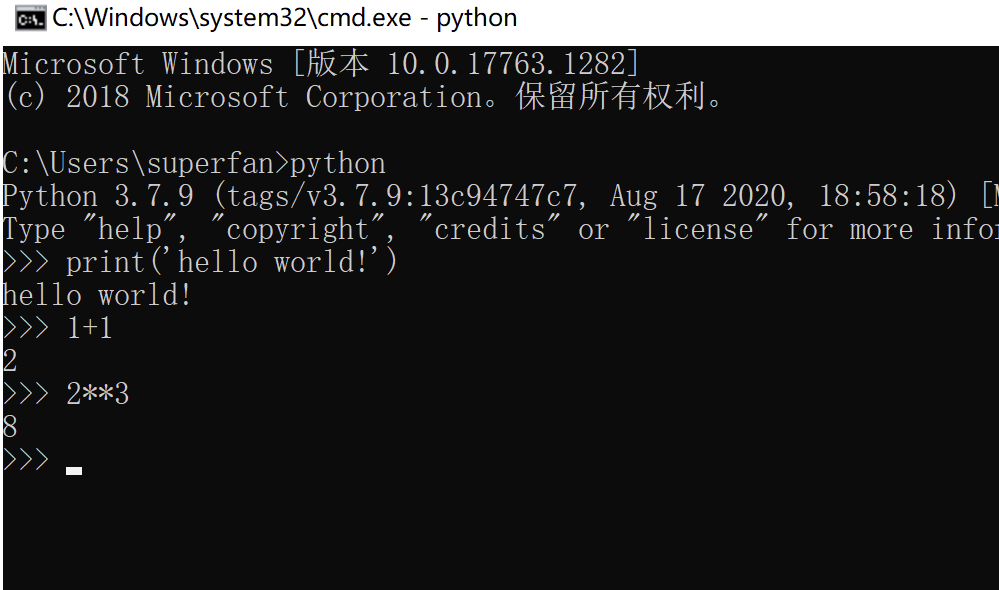
交互式
在命令行窗口输入命令
python进入python解释器交互式客户端,在窗口中输入任意python代码,客户端窗口都会立即返回运行结
果,当关闭客户端窗口后,代码不会保存。这种方式一般用来进行测试,不是正式的运行方式。
脚本式
任意文本编辑工具都可以进行python代码的编写 ,在桌面新建一个文本文档,写入如下代码
print('hello world')然后保存(尽量不要使用记事本直接编辑代码)。现在这个文本文档就是一个python的源代码文件,通 常称为python脚本文件,通常我们会将python脚本文件的后缀改为 .py 。
python代码本质上是通过python解释器解释成机器码后交由计算机执行的。
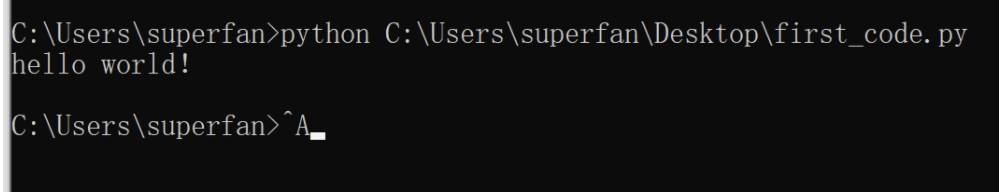
在命令行输入命令
python 脚本文件路径就可以运行对应的脚本代码。
练习作业
搭建好python运行环境后编写如下脚本然后运行试试看。
from turtle import *
color('red', 'yellow')
begin_fill()
while True:
    forward(200)
    left(170)
    if abs(pos()) < 1:
        break
end_fill()
done()
注意每层缩进都是4个空格。
文件概述
什么是文件
计算机文件是一个存储在存储器上的数据序列,可以包含任何数据内容。概念上,文件是数据的集合和抽象。用文件形式组织和表达数据更有效也更为灵活。文件包括两种类型:文本文件和二进制文件。
文件本质上都是存储在存储器上的二进制数据。
使用HexEditor可以以16进制的方式打开任何文件。
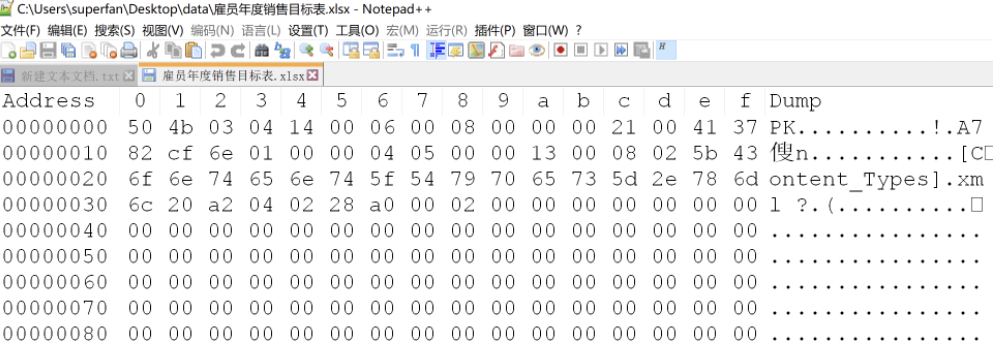
特别的是文本文件遵循统一的字符编码,在打开时,计算机会根据字符编码解析成编码表上对应的字符。
二进制文件和文本文件本质上没有区别,只是没有统一的编码,需要根据特定的程序进行解析和运行。
无论是文本文件还是二进制文件都可以用"文本文件方式"和"二进制文件方式"打开,打开后的操作不同。
字符编码
计算机底层只能表示二进制信息,不能直接表示文字。计算机显示给我们看的文字可以看做是很小的一张张字符的图片。但如果文字都以图片进行存储和传输,图片体积非常大,从而效率会变得很低。
所以计算机科学家将这些单个字符图片放到一个文件中,这个文件就是字体文件。再给每个字符一个编号,存储传输时就用字符的编号。这个编号表就是字符编码(简单这么理解)。
文本文件存储的就是每个字符的编号,计算机在打开文本文件时,会根据指定的编码,去编码表中查询一个一个的字符,再渲染给用户。
ascii码
因为历史原因,字符编码有很多。最先发明的是ascii码。
总共127个字符,因此使用一个字节(8位二进制)来表示,也即是一个字符占一个字节的大小。
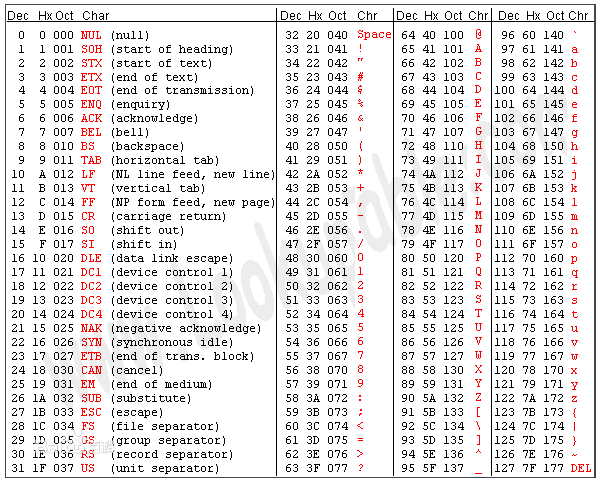
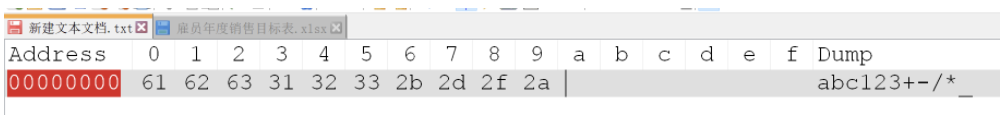
在记事本中键入abc123+-*/,然后使用HexEditor打开后发现跟上面的编码表是一致的。
gb2312
可以看到ascii码里只有英文字母和常见字符,没有中文,以及世界上其他国家的文字。随着计算机的发展,各国都创建了自己国家的计算机字符编码。
1980年中国发布了gb2312, GB2312是一个简体中文字符集,由6763个常用汉字和682个全角的非汉字字符组成。
gb2312使用两个字节表示一个汉字。
通过字符串的encode方法可以根据字符编码进行编码
'中'.encode('gb2312')b'\xd6\xd0'
gbk
GB2312的出现,基本满足了汉字的计算机处理需要,但对于人名、古汉语等方面出现的罕用字,GB 2312不能处理,这导致了后来GBK及GB18030汉字字符集的出现。
GBK即汉字内码扩展规范,K为扩展的汉语拼音中“扩”字的声母。GBK编码标准兼容GB2312,共收录汉字21003个、符号883个,并提供1894个造字码位,简、繁体字融于一库。
gbk也是使用两个字节表示一个汉字。
'中'.encode('gbk')b'\xd6\xd0'
'囙'.encode('gb2312')UnicodeEncodeError Traceback (most recent call last)
in <module> ----> 1 '囙'.encode('gb2312')
UnicodeEncodeError: 'gb2312' codec can't encode character '\u56d9' in position 0: illegal multibyte sequence
'囙'.encode('gbk')b'\x87\xe0'
unicode
世界上存在着多种编码方式,同一个编码值,在不同的编码体系里代表着不同的字。要想打开一个文本文件,不但要知道它的编码方式,还要安装有对应编码表,否则就可能无法读取或出现乱码。
我上大学时玩电脑游戏最大的问题就是乱码。
以日文的编码方式创建一个文本文件写入やめて,然后用记事本打开会显示如下:
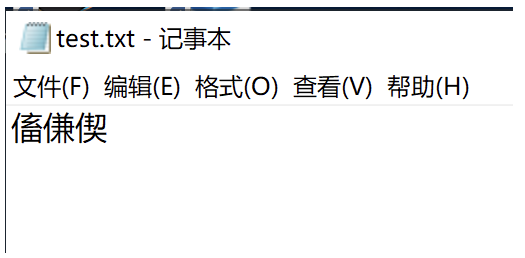
这个问题促使了unicode码的诞生。
unicode将世界上所有的符号都纳入其中,无论是英文、日文、还是中文等,大家都使用这个编码表,就不会出现编码不匹配现象。每个符号对应一个唯一的编码,乱码问题就不存在了。
Unicode固然统一了编码方式,但是它的效率不高,比如UCS-4(Unicode的标准之一)规定用4个字节存储一个符号,那么每个英文字母前都必然有三个字节是0,这对存储和传输来说都很耗资源。
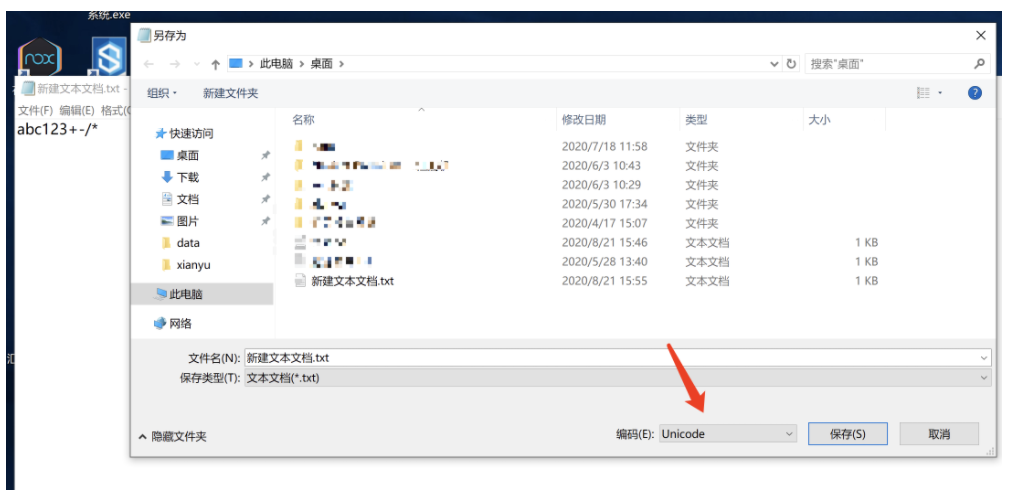
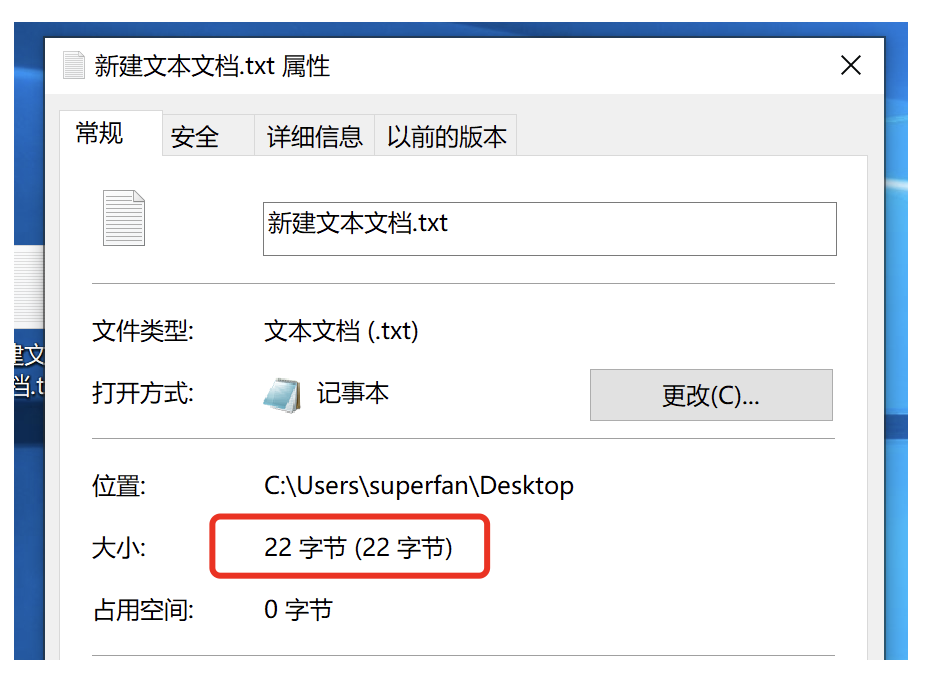
将之前写有abc123+-*\的文件用记事本另存为unicode会发现文件的体积大了一倍。(本来应该是4倍,windows做了优化)
utf-8
为了提高Unicode的编码效率,于是就出现了UTF-8编码。UTF-8可以根据不同的符号自动选择编码的长短。比如英文字母可以只用1个字节就够了。"汉"字的Unicode编码是U+00006C49,然后把U+00006C49通过UTF-8编码器进行编码,最后输出的UTF-8编码是E6B189。utf-8中汉字使用3个字节存储。
'a'.encode('utf-8')b'a'
'中'.encode('utf-8')b'\xe4\xb8\xad' 注意为了统一python3在内存中所有的字符都采用unicode。
来源:testingpai