本文目录
- 开发流程
- 一、明确目标数据
- 二、分析数据请求流程
- 三、 发送请求
- 四.解析数据
- 五、数据持久化
技术文章
—— 网站上看到了大量好看的图片再也不用右键另存为了针对人群:对 python 感兴趣的零基础的童靴有一定基础想深入了解 python 的童靴涉及知识:网络爬虫的本质http 协议requests 库收获:认识网络爬虫的本质,掌握爬虫的基本...
—— 网站上看到了大量好看的图片再也不用右键另存为了
认识网络爬虫的本质,掌握爬虫的基本开发流程,了解互联网数据传输的基本原理。
理论指导实践,知其然要知其所以然,我们先来学习必备的理论知识。
网络爬虫也叫网络蜘蛛,它特指一类自动批量下载网络资源的程序,这是一个比较口语化的定义。更加专业和全面的定义是:网络爬虫是伪装成客户端与服务端进行数据交互的程序。
口语化的定义相信大家都能理解,不能理解的童靴请自觉面壁!
但是后面的客户端,服务端肯定有童靴不理解了,这就涉及下一个概念了。
商业应用推动了互联网的飞速发展,目前几乎所有的商业应用都是基于互联网的,它们一般采用 c/s 架构,b/s 架构或 m/s 架构。
安装在用户电脑中的程序叫客户端,例如 LOL,例如 QQ,例如腾讯课堂等。
为客户端提供服务支持的,运行在服务厂商服务器中的程序叫服务端。
A 用户在 QQ 中给 B 用户发送一条信息的过程是:
A 发送的信息首先发送到服务器,服务器再将这个信息发送给 B 接收。
特别的,当客户端是浏览器时,我们单独作为一种架构叫做 b/s 架构,例如各种网站;
当客户端是移动端上的 APP 时,我们单独作为一种架构叫做 m/s 架构,例如各种手机 APP。
所以:本质上 b/s,m/s 也是 c/s 的一种!
那客户端和服务端是如何进行通信的呢?(网络通信涉及物理层和应用层,我们这里讨论应用层!)
不同的客户端和不同服务端进行数据交互,为了统一大家制定了各种传输协议。
最开始每个团队设计的客户端和服务端之间的数据方式都不一样,为了提高开发效率和资源利用大家统一制定了各种应用传输协议。
1、http 超文本传输协议
2、ftp 文件传输协议
3、smtp 电子邮件传输协议
因为大多数爬虫都是爬取的网页中的信息,所以我们今天主要了解 HTTP 协议。
http 协议有厚厚一本书,今天我们讲主要流程,感兴趣的童靴听完课后就可以去收集资料钻研啦。
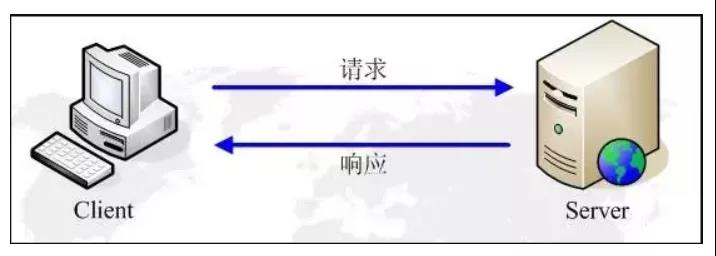
一个基于 http 协议的数据传输分为 2 个部分,请求和响应。
客户端向服务端发送一个 http 请求,服务端收到这个请求后根据请求进行处理,然后将结果以 http 响应的形式返回给客户端。
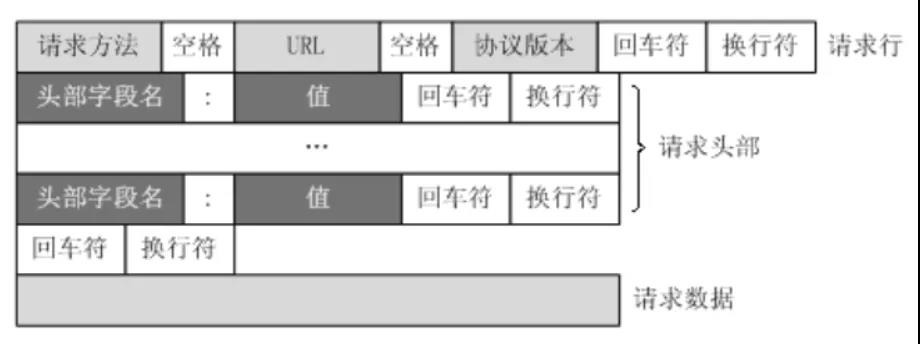
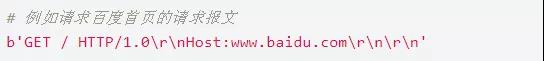
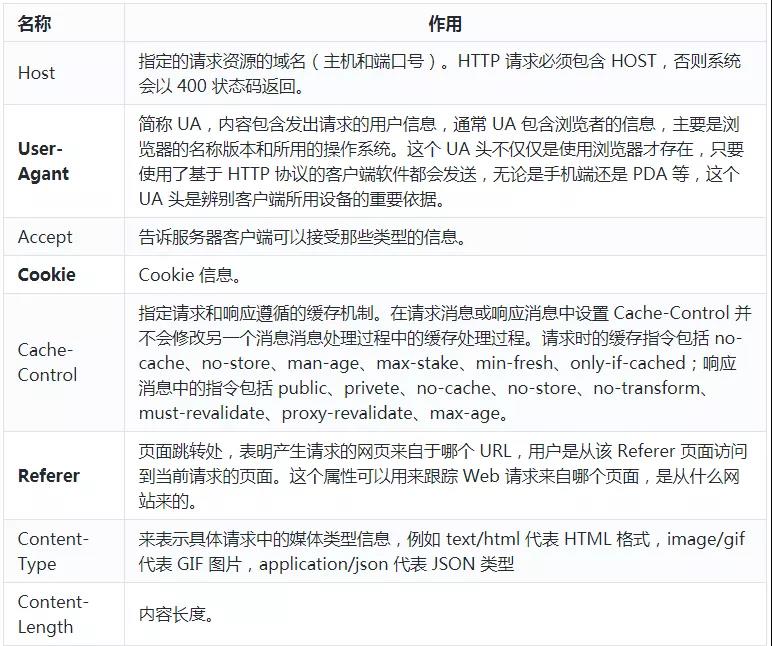
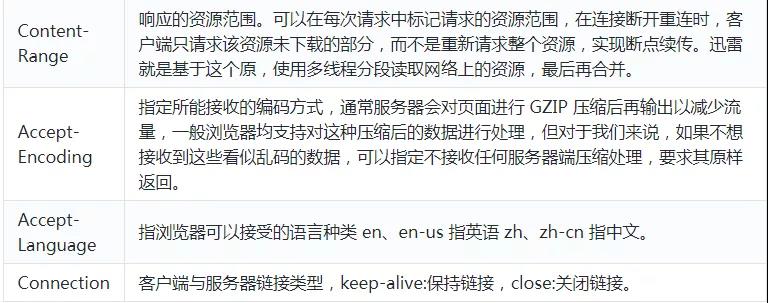
一个完整的 HTTP 请求报文包含:请求行,请求头,空行和请求数据。
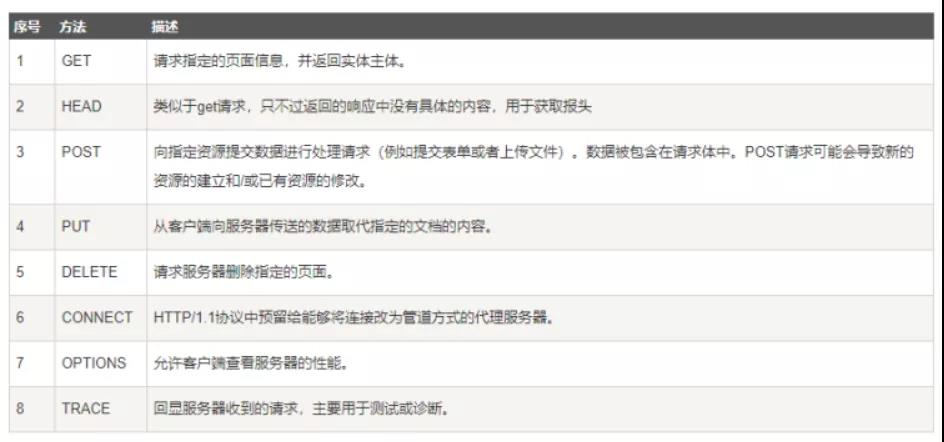
请求方法
根据 http 标准,http 请求可以使用多种请求方法。
1.0 定义了三种请求方法:GET,POST 和 HEAD 方法
1.1 新增了五种请求方法:OPTIONS,PUT,DELETE,TRACE 和 CONNECT 方法。
简单来说,GET 方法一般用来获取数据,或者将一些简短的数据放到 URL 参数中传递到服务器。比 POST 更加高效和方便。
由于 GET 方法最多在 url 中携带 1024 字节数据,且将数据放到 URL 中传递太不安全,数据量大时 URL 也会变得冗长。所以传递数据量大或者安全性要求高的数据的时候,最好使用 POST 方法来传递数据。
请求数据通常是使用 POST 方法进行发送的,GET 方法是没有请求数据的。
讲到这里,我们可以看出所谓的协议就是数据的统一组织格式。
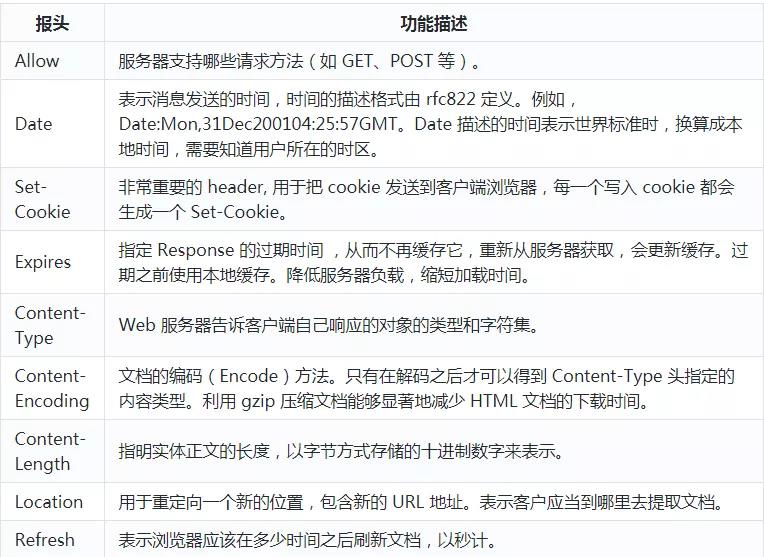
一个完整的 HTTP 响应报文也由四个部分组成,分别是:状态行,消息报头,空行和响应正文。
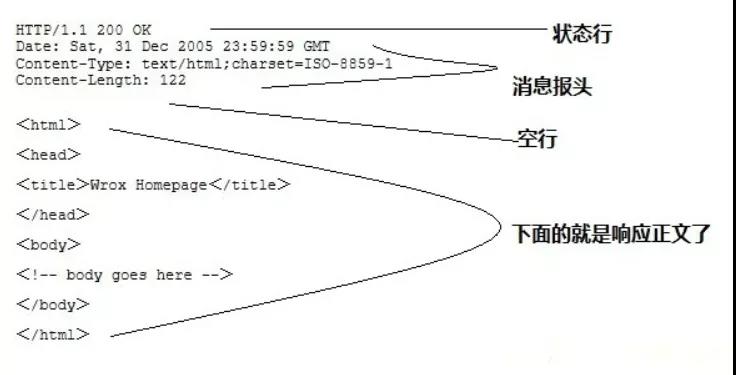
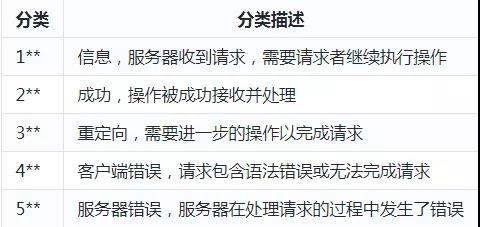
当客户端向服务端发起一次请求后,服务端在返回的响应头中会包含一个 HTTP 状态码。
HTTP 的状态码是由三位数字来表示的,由第一位数字来表示状态码的类型,一般来说有五种类型:
可以把一个 http 事务比作通过暗号打电话,客户端向服务端打电话接通后客户端先说话,服务端根据客户端的暗号选择回复内容。
1、HTTP 是无连接的:无连接的含义是限制每次连接只处理一个请求。服务器处理完客户的请求,并收到客户的应答后,即断开连接。采用这种方式可以节省传输时间。
2、HTTP 是媒体独立的:这意味着,只要客户端和服务器知道如何处理的数据内容,任何类型的数据都可以通过 HTTP 发送。客户端以及服务器指定使用适合的 MIME-type 内容类型。
3、HTTP 是无状态:HTTP 协议是无状态协议。无状态是指协议对于事务处理没有记忆能力。缺少状态意味着如果后续处理需要前面的信息,则它必须重传,这样可能导致每次连接传送的数据量增大。另一方面,在服务器不需要先前信息时它的应答就较快。
讲完 HTTP 协议之后,我们首先来简单了解一下浏览器的工作原理。
2、浏览器会向这个网址所指向的服务器发起一个 http 请求
4、浏览器从上往下解析渲染响应回来的 HTML 文档
5、在解析渲染的过程中碰到其他资源浏览器继续向服务器发送请求
1、浏览器打开一个页面时所有的数据都是从服务下载回来的
2、浏览器打开一个页面第一个 http 请求下载的是网页的 HTML 文档
3、浏览器打开一个页面一般会发送多个 http 请求
能够通过互联获取的网页,图片,视频,音频,其他文件等信息的集合。
爬虫的目标就是网络资源。网络那么大,怎么定位网络资源呢?如何用浏览器打开淘宝首页,下载某个文件?
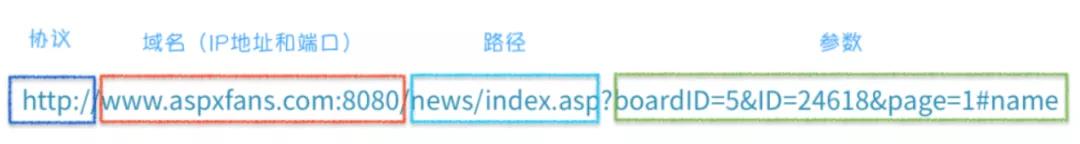
URL(Uniform Resource Locator),中文叫统一资源定位符。是用来标识某一处网络资源的地址。
也即是我们常说的网址。以下面这个 URL 为例,介绍下普通 URL 的各部分组成:
开发流程
网络爬虫的本质就是模拟客户端发送请求,一个爬虫的基本开发流程包含五步:
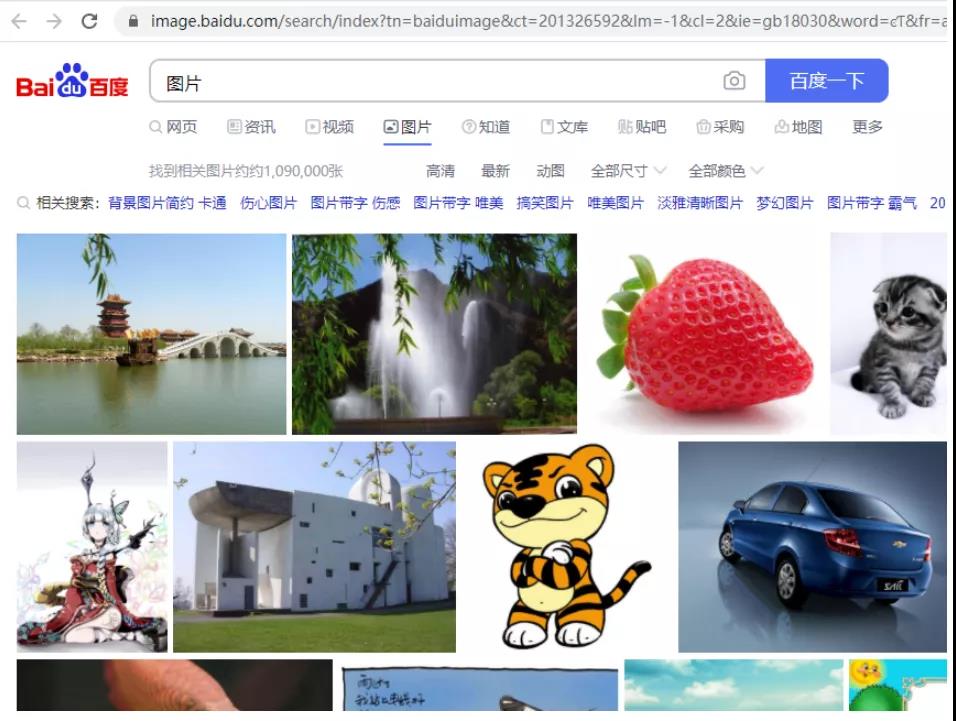
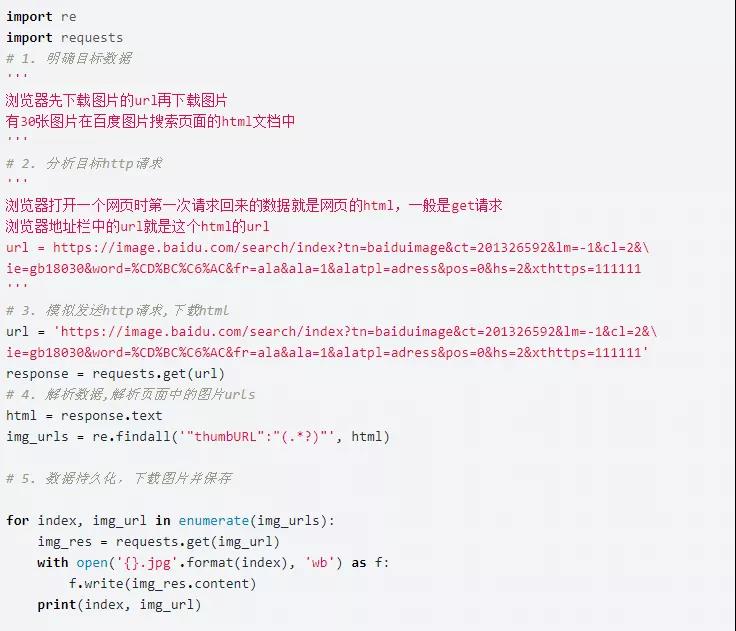
一、明确目标数据
网页中的图片是浏览器通过 http 请求下载回来的。
浏览器会先下载图片的 url,再通过 url 下载图片。
所以我们只要找到图片 url 的 http 请求即可。
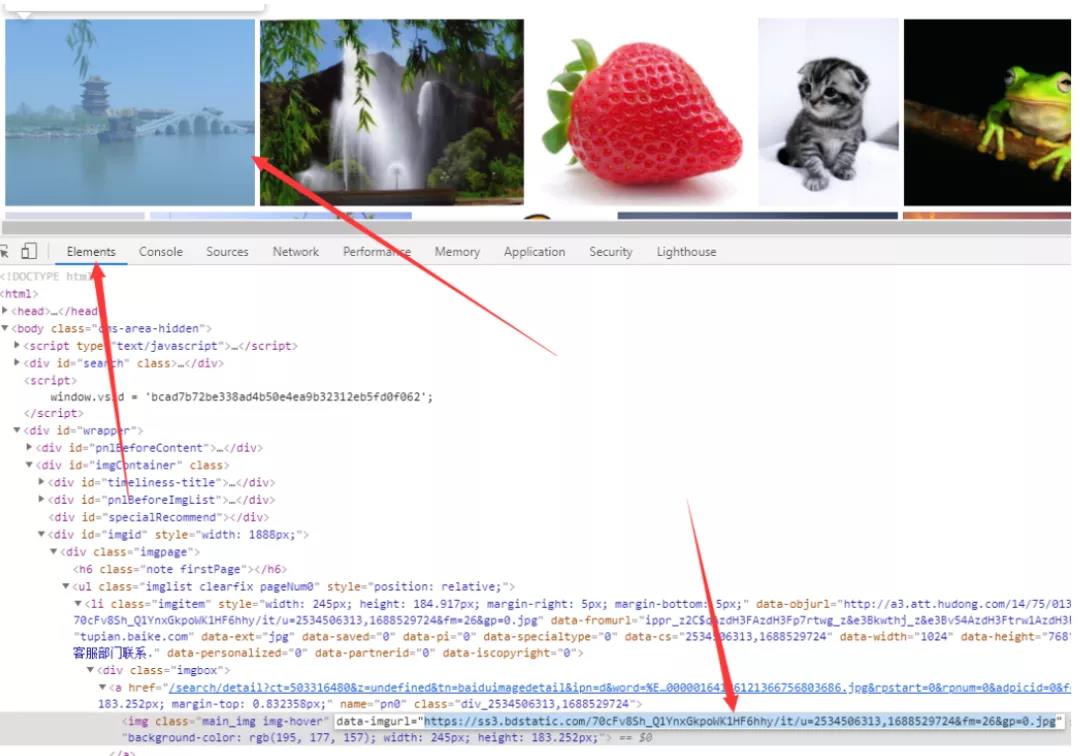
一般情况下,页面中的图片 url 就包含在页面的 HTML 文档中,使用谷歌浏览器开发者调试工具获取图片的 url
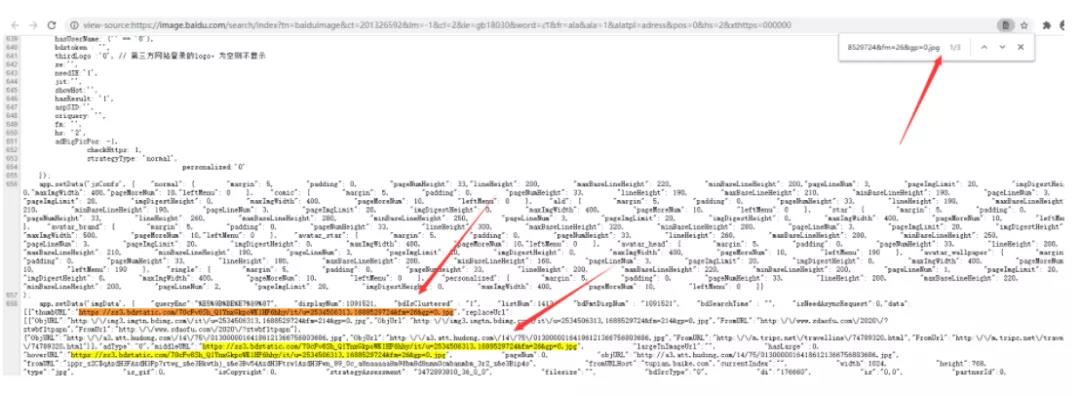
然后右键查看网页源文件可以查看当前页面的 HTML 文档
ctrl+f 调出搜索框,把前面找到的图片的 url 粘贴进来,果然发现了 url 就在 HTML 中
为了稳妥可以多找几张图片的 url 测试。发现页面中的前 30 张图片的 url 都在 HTML 文档中。
二、分析数据请求流程
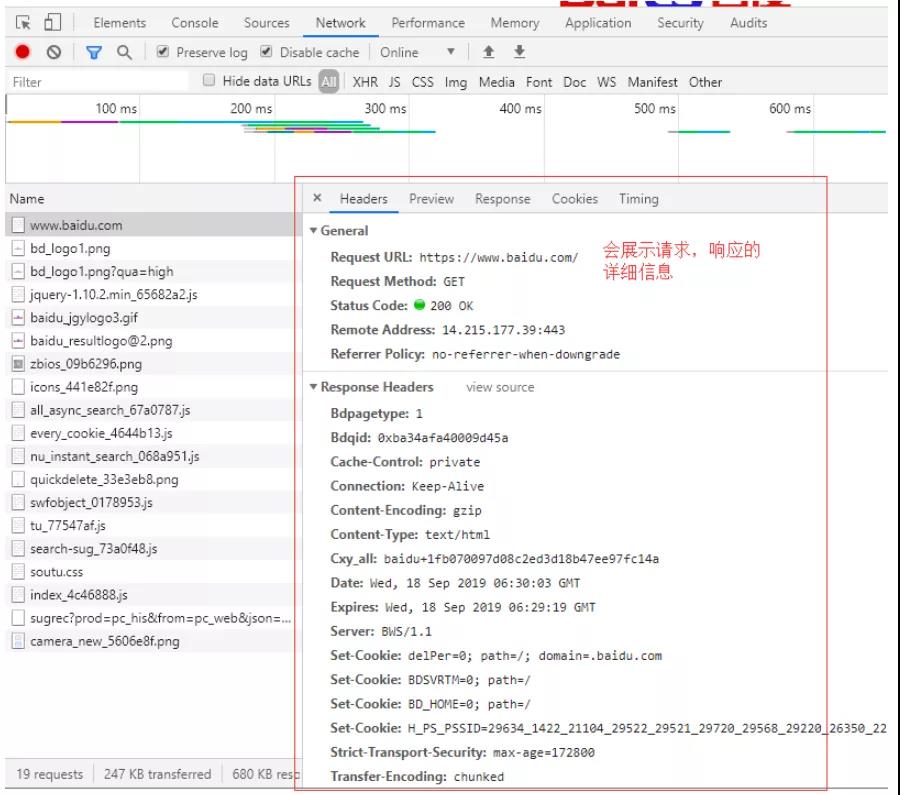
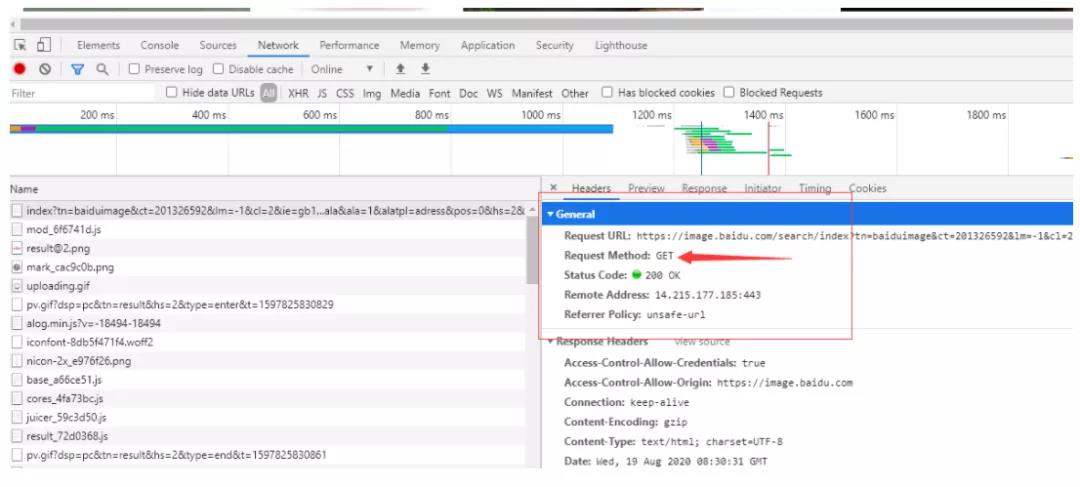
分析请求流程的目的找到目标资源的 http 请求,根据前面学习的 HTTP 协议知识,分析请求流程的具体信息是:
1.1 工具
在 HTTP 协议中信息以二进制的形式进行传输的,我们需要借助工具来分析 HTTP 请求。常用工具有,谷歌浏览器和 fiddler。
1.1.1 fiddler
fiddler 的使用和安装相对复杂,谷歌浏览器可以满足大部分的请求流程分析,这里主要介绍谷歌浏览器。
1.1.2 谷歌浏览器
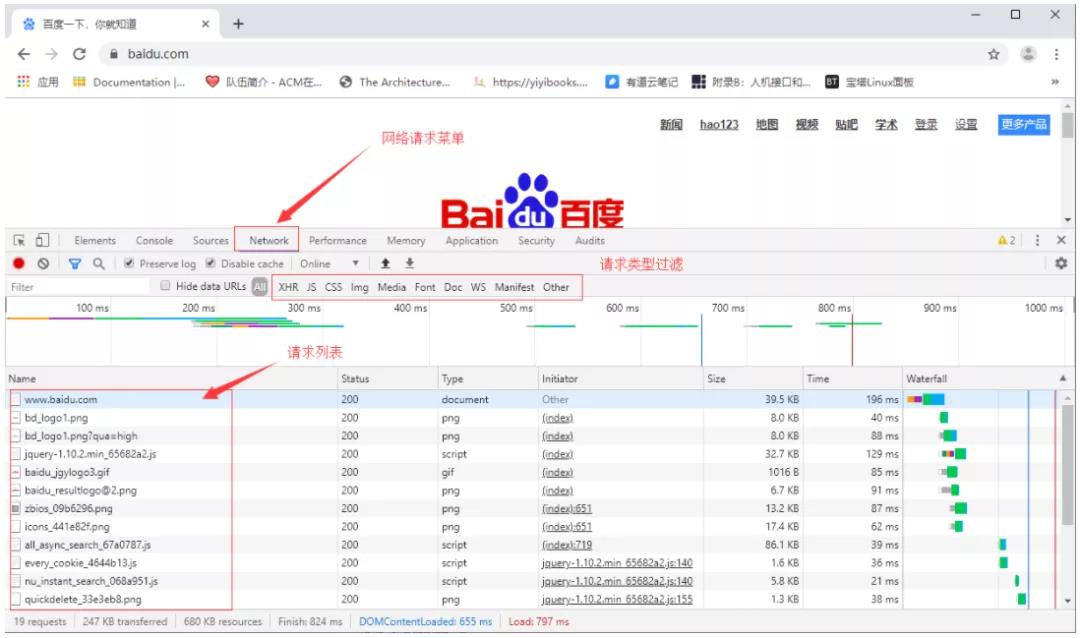
谷歌浏览器提供了开发者调试工具,能够对浏览器的 HTTP 请求进行监控,按功能键 F12 即可打开工具界面,功能窗口如下:
2、url:https://image.baidu.com/search/index?tn=baiduimage&ct=201326592&lm=-1&cl=2&ie=gb18030&word=%CD%BC%C6%AC&fr=ala&ala=1&alatpl=adress&pos=0&hs=2&xthttps=000000
三、 发送请求
分析清楚目标资源的请求过程后,就需要通过代码模拟发送请求。
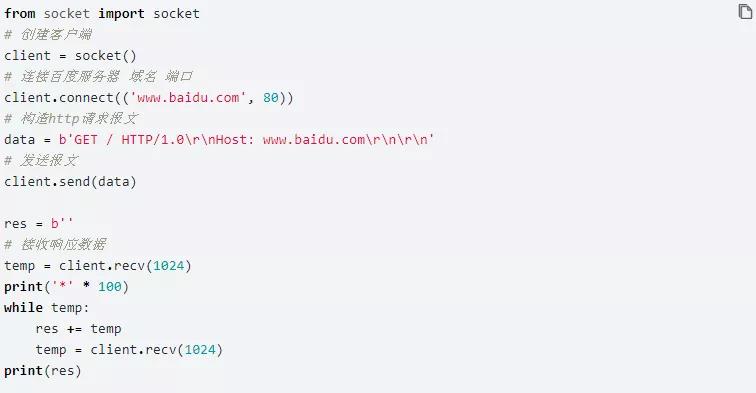
通过 socket 发送 HTTP 请求
工具库
上面我们通过使用 socket 实现了一个非常简单的请求的发送,可以看到代码比较复杂,如果需要传递更多信息,处理起来会更繁琐,费时费力。python 提供了很多的库,将发送 HTTP 请求的细节进行了封装,只需要进行简单的调用就可以实现各种 http 请求的发送,常用的库有:
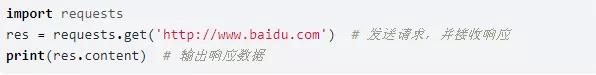
使用 requests 发送请求
四.解析数据
响应正文及响应数据一般分为两大类,文本数据和二进制数据。
其中文本数据又分为 HTML 和 JSON(注:主要指爬虫目标数据,js,CSS 等也属于文本数据)。
HTML 解析
今天的案例数据包含在 HTML 文档中,所以需要解析 HTML
1、正在表达式
2、HTML 解析库
五、数据持久化
爬虫爬取到的数据需要存储起来,对于少量的数据,生成相应的文件,例如 Excel,cvs 等。
如果要保存大量的文本信息,例如商品信息,订单信息等,就需要存储到数据库中。
代码
说明:本文为柠檬班心蓝老师原创,转载需注明出处
| 有任何问题都欢迎来评论私信讨论哦~加软件测试交流QQ群:972956275还可获取免费测试学习视频干货资料哦! |
 柠檬班