 柠檬班
Python入门三部曲 | 第一节课:基础入门
三节课让你弄清自己适不适合学编程针对人群:零基础想学python,又怕自己学不会,怀疑自己是不是适合学习编程的童鞋。这一节课主要是扫盲,很多同学可能连python运行环境都没有搭建好。python是一门解释型编程语言,python代码是通过...
三节课让你弄清自己适不适合学编程
python是一门解释型编程语言,python代码是通过python解释器解释后交给计算机执行的。
目前python有两个大的版本,2.X和3.X。2.X是遗产,3.X是未来。除非特殊情况,新手建议学习3.X。
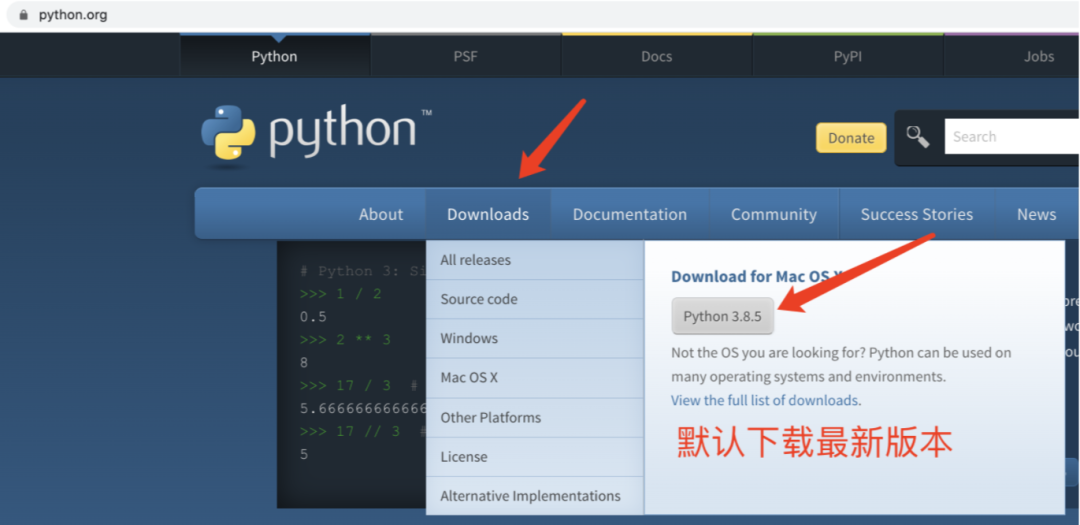
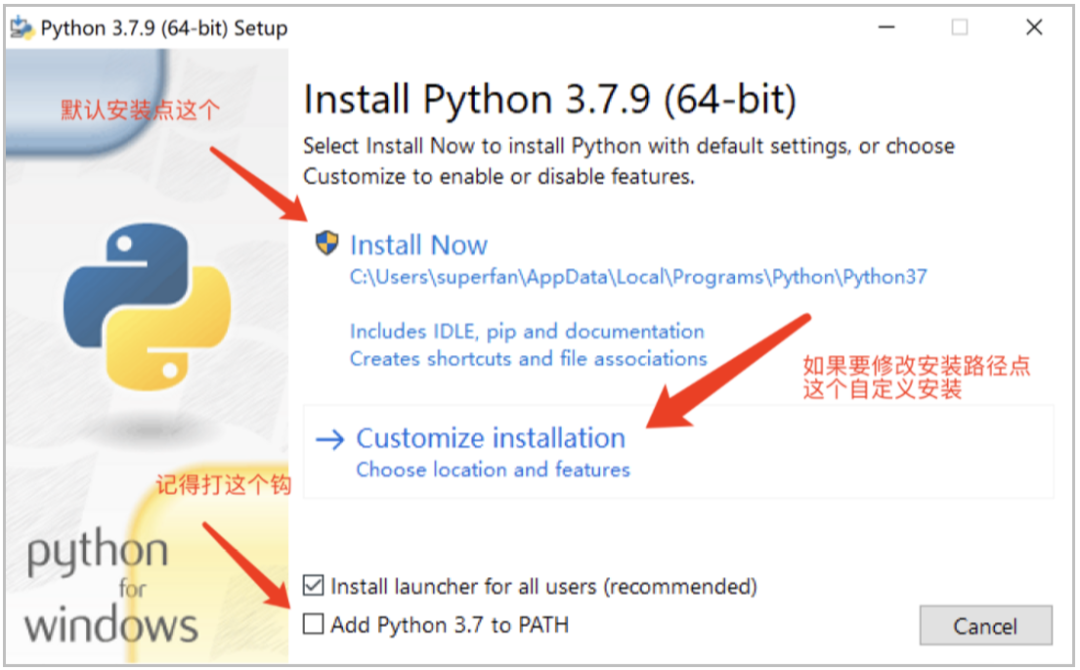
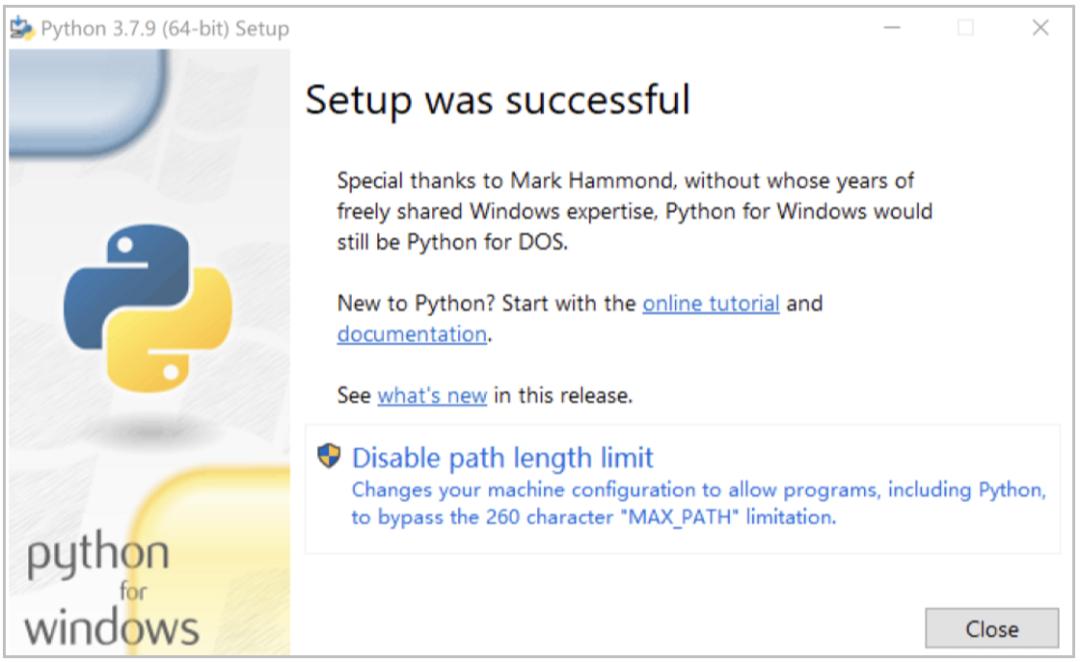
下载后双击安装文件会出现如下界面
全黑的窗口,满屏的像瀑布一样流动的英文,这是电影中黑客出场的画面。
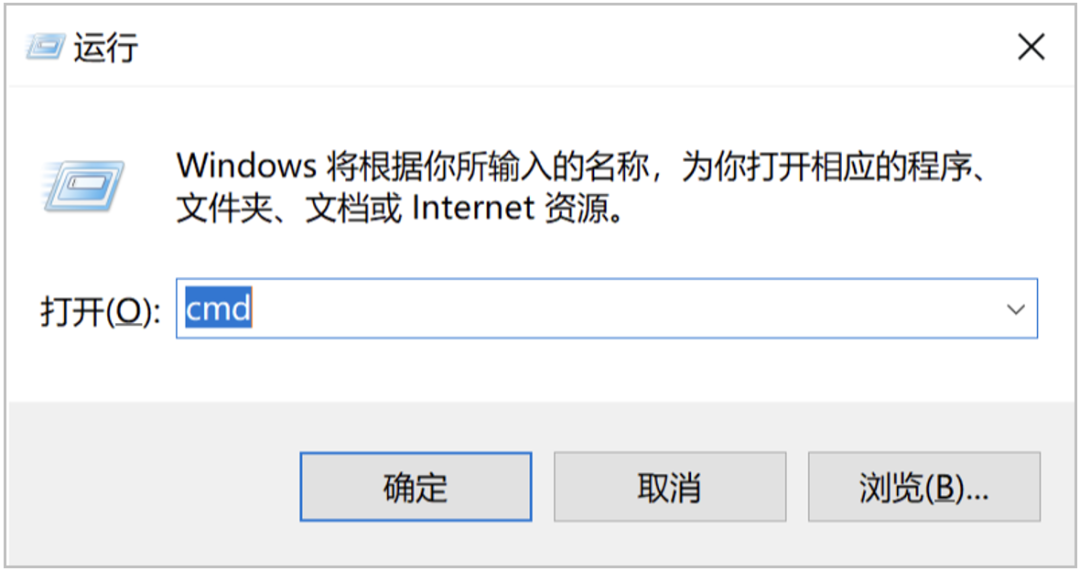
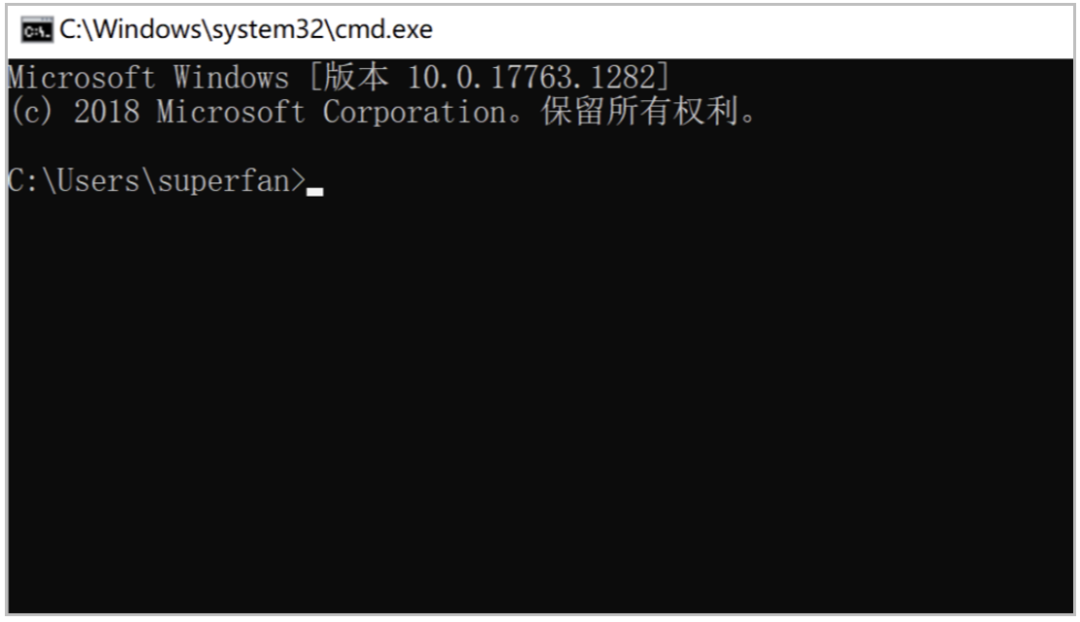
输入 cmd 确定就会打开命令行工具。一般情况会打开如下窗口

那是因为记事本这个程序的程序名就是notepad.exe,机灵的小可爱就会联想QQ的程序名是 qq.exe那么,那么在命令行中输入QQ是不是也可以打开 QQ 呢?
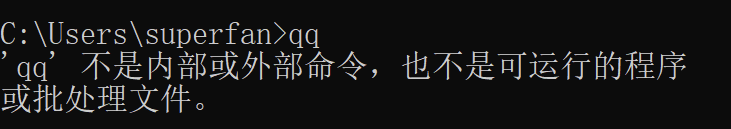
这是为什么呢?其实 cmd 在接收到用户输入的命令后,会去电脑中搜索同名的程序或者批处理等文件,但是为了效率,它不会查找每个文件夹。
右键【我的电脑】-【属性】-【高级系统设置】-【环境变量】
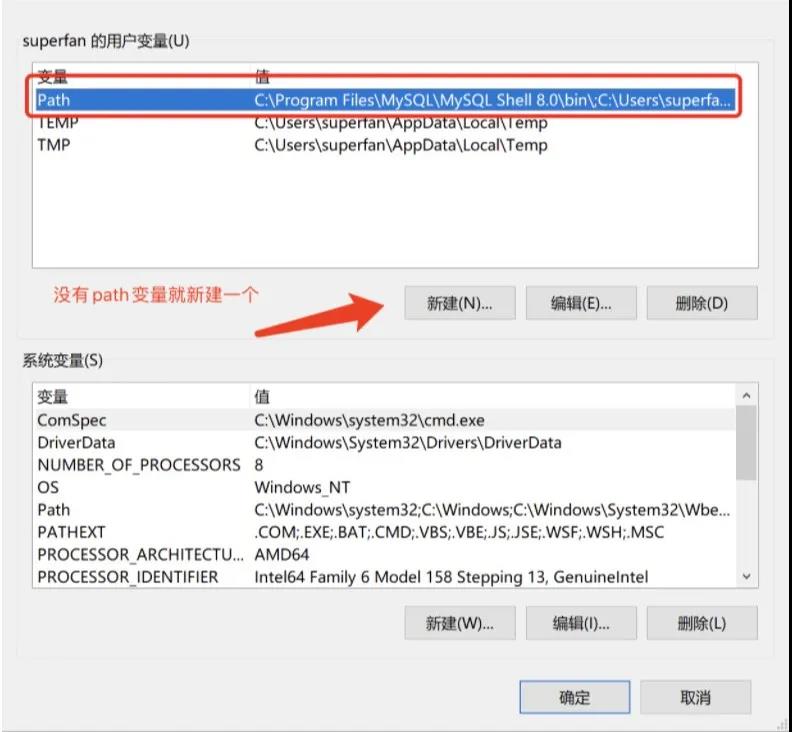
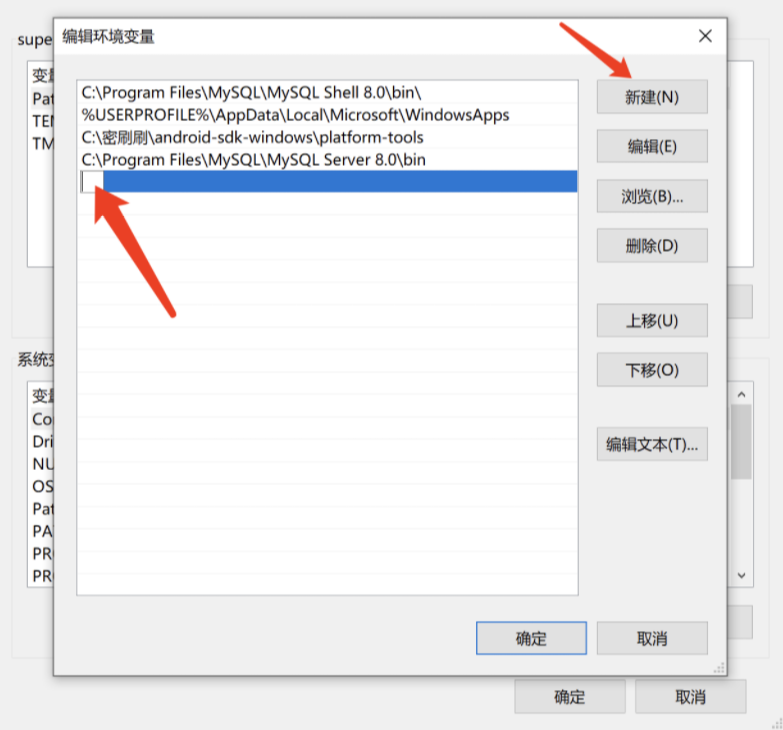
然后重新打开命令行工具应用新的环境变量,再次键入 qq 你就可以打开 QQ 啦。
如果在安装 python 解释器的时候忘记勾选添加环境变量,也可以通过手动设置环境变量,然后在命令行中就可以运行 python 命令啦。
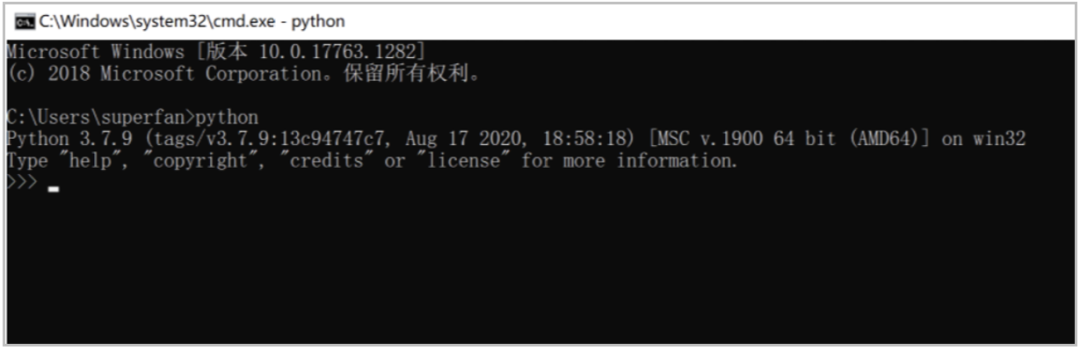
python 代码的运行方式有两种:
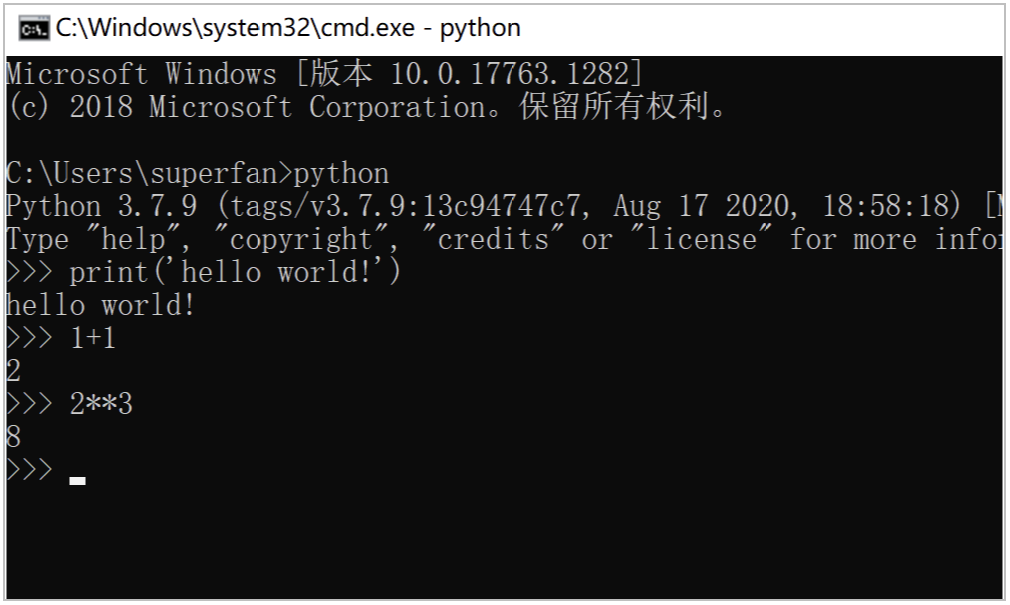
在命令行窗口输入命令

进入 python 解释器交互式客户端,在窗口中输入任意 python 代码,客户端窗口都会立即返回运行结果,当关闭客户端窗口后,代码不会保存。这种方式一般用来进行测试,不是正式的运行方式。
任意文本编辑工具都可以进行 python 代码的编写 ,在桌面新建一个文本文档,写入如下代码

然后保存(尽量不要使用记事本直接编辑代码)。现在这个文本文档就是一个 python 的源代码文件,通常称为 python 脚本文件,通常我们会将 python 脚本文件的后缀改为 .py 。
python 代码本质上是通过 python 解释器解释成机器码后交由计算机执行的。
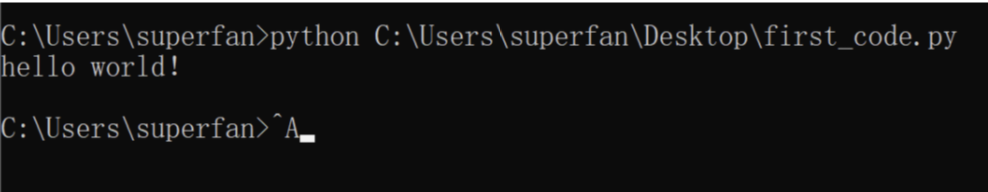
在命令行输入命令

就可以运行对应的脚本代码。
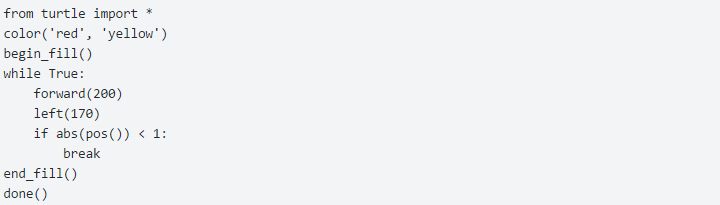
注意每层缩进都是 4 个空格。
计算机文件是一个存储在存储器上的数据序列,可以包含任何数据内容。概念上,文件是数据的集合和抽象。用文件形式组织和表达数据更有效也更为灵活。文件包括两种类型:文本文件和二进制文件。
文件本质上都是存储在存储器上的二进制数据。
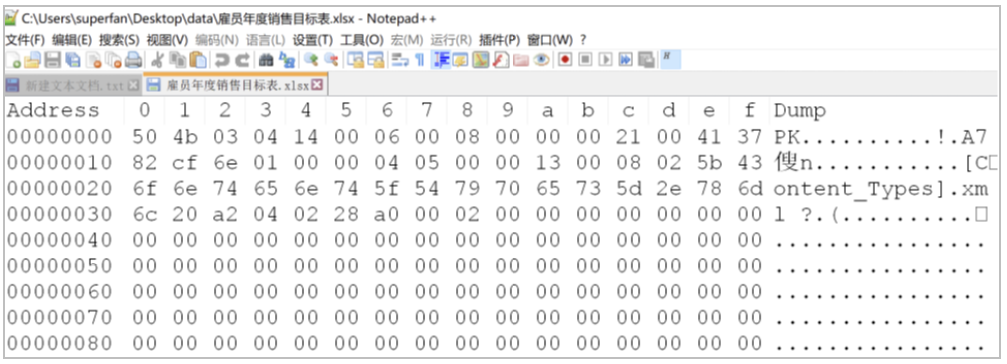
遵循统一的字符编码,在打开时,计算机会根据字符编码解析成编码表上对应的字符。
二进制文件和文本文件本质上没有区别,只是没有统一的编码,需要根据特定的程序进行解析和运行。
因为历史原因,字符编码有很多。最先发明的是 ascii 码。
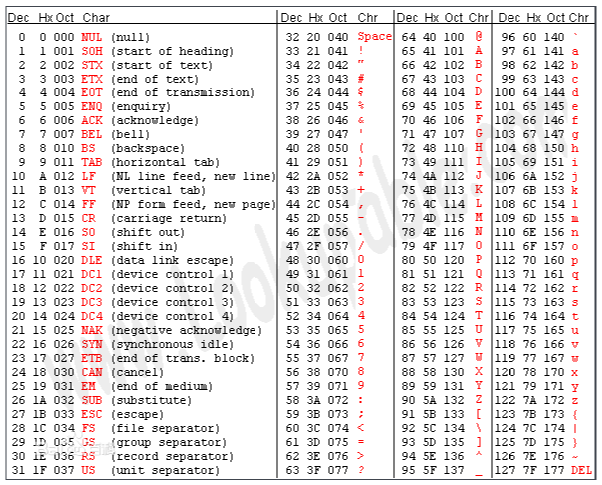

可以看到 ascii 码里只有英文字母和常见字符,没有中文,以及世界上其他国家的文字。随着计算机的发展,各国都创建了自己国家的计算机字符编码。
1980 年中国发布了 gb2312, GB2312 是一个简体中文字符集,由 6763 个常用汉字和 682 个全角的非汉字字符组成。
gb2312 使用两个字节表示一个汉字。
通过字符串的 encode 方法可以根据字符编码进行编码

b'\xd6\xd0'
GB2312的出现,基本满足了汉字的计算机处理需要,但对于人名、古汉语等方面出现的罕用字,GB 2312不能处理,这导致了后来 GBK及GB18030 汉字字符集的出现。
GBK即汉字内码扩展规范,K为扩展的汉语拼音中“扩”字的声母。GBK编码标准兼容 GB2312,共收录汉字21003个、符号883个,并提供1894个造字码位,简、繁体字融于一库。
gbk 也是使用两个字节表示一个汉字。

b'\xd6\xd0'

----> 1 '囙'.encode('gb2312')
b'\x87\xe0'
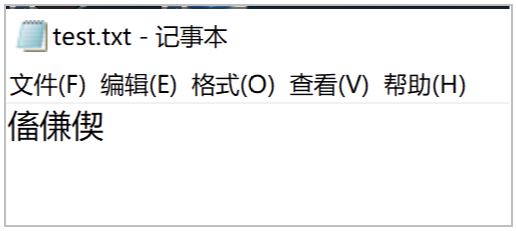
世界上存在多种编码方式,同一个编码值,在不同编码体系里代表着不同的字。要想打开一个文本文件,不但要知道它的编码方式,还要安装有对应编码表,否则就可能无法读取或出现乱码。
我上大学时玩电脑游戏最大的问题就是乱码。
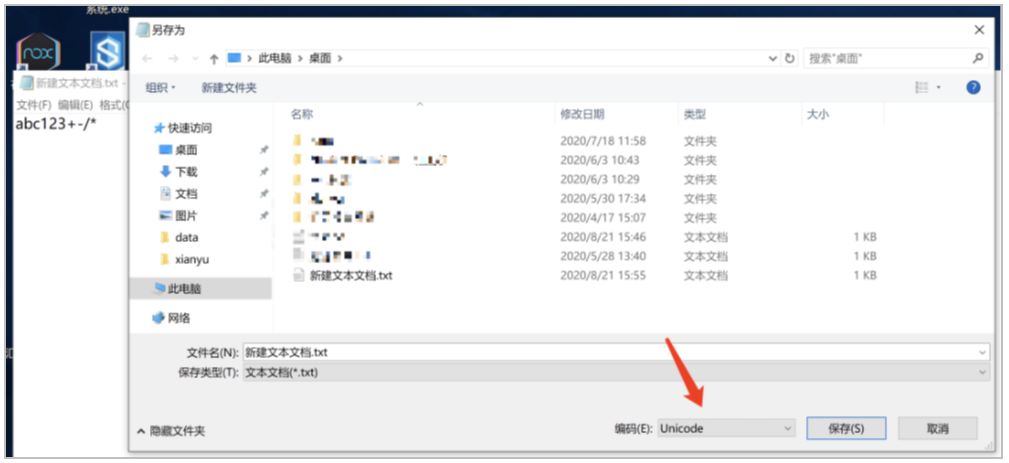
这个问题促使了 unicode 码的诞生。
unicode 将世界上所有的符号都纳入其中,无论是英文、日文、还是中文等,大家都使用这个编码表,就不会出现编码不匹配现象。每个符号对应一个唯一的编码,乱码问题就不存在了。
Unicode 固然统一了编码方式,但是它的效率不高,比如 UCS-4(Unicode 的标准之一)规定用 4 个字节存储一个符号,那么每个英文字母前都必然有三个字节是 0,这对存储和传输来说都很耗资源。
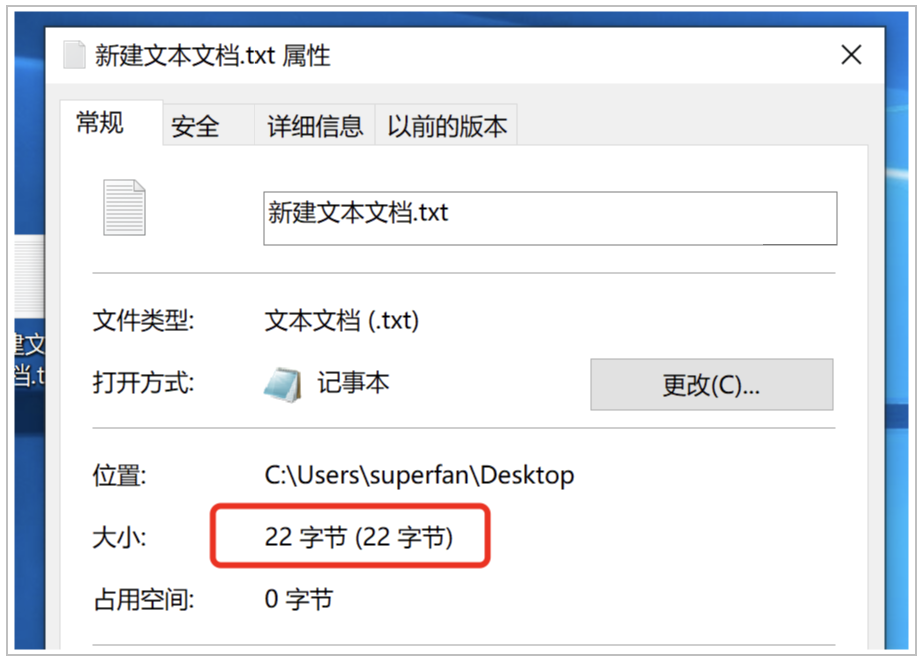

为了提高 Unicode 的编码效率,于是就出现了 UTF-8 编码。UTF-8 可以根据不同的符号自动选择编码的长短。比如英文字母可以只用 1 个字节就够了。"汉"字的 Unicode 编码是 U+00006C49,然后把 U+00006C49 通过 UTF-8 编码器进行编码,最后输出的 UTF-8 编码是 E6B189。utf-8 中汉字使用 3 个字节存储。

注意为了统一 python3 在内存中所有的字符都采用 unicode。
说明:本文为柠檬班心蓝老师原创,转载需注明出处
| 有任何问题都欢迎来评论私信讨论哦~加微信13327216815或者软件测试交流QQ群:972956275,备注:官网,还可获取免费测试学习视频干货资料哦! |